
 BitFlip27

Como Gerar Texto com o GPT-Neo em GPUs com Memória Limitada: Um Guia Passo a Passo
Gerar texto com modelos de linguagem grandes como o GPT-Neo pode parecer um desafio, especialmente quando você está trabalhando com hardware limitado, como GPUs com pouca memória. Neste guia, vamos ensinar como configurar o GPT-Neo, lidar com as limitações de memória da GPU e gerar texto de forma eficiente. Também mostraremos como salvar as respostas geradas em um arquivo de texto com informações detalhadas, incluindo o horário, a pergunta e o tempo de resposta.
O sistema foi configurado utilizando o Jupyter Notebook, uma poderosa plataforma interativa amplamente utilizada por desenvolvedores e cientistas de dados para executar e testar códigos em tempo real. Para garantir um desempenho ideal durante a execução do modelo GPT-Neo, todos os drivers de hardware, especialmente os da GPU, foram atualizados para as versões mais recentes disponíveis. Essa atualização é fundamental para aproveitar ao máximo os recursos da GPU, corrigindo possíveis bugs e otimizando a compatibilidade com bibliotecas como PyTorch e CUDA. Além disso, o uso do Jupyter Notebook facilitou a visualização dos resultados e ajustes no código, permitindo uma experiência mais fluida e eficiente durante o processo de configuração e execução.
O que é o GPT-Neo?
GPT-Neo é um modelo de linguagem de código aberto desenvolvido pela EleutherAI, projetado para realizar tarefas de geração de texto, semelhante ao GPT-3 da OpenAI. É uma excelente opção para desenvolvedores que procuram um modelo robusto sem custos associados.
No entanto, sua grande capacidade também significa que ele exige recursos computacionais significativos. Modelos como o GPT-Neo-2.7B necessitam de GPUs com grande quantidade de memória, mas com as otimizações adequadas, você pode executá-lo em hardware mais limitado.
Passo 1: Configurando o Ambiente
Antes de começar, certifique-se de ter as ferramentas e bibliotecas necessárias instaladas.
Pré-requisitos
- Python 3.8 ou superior: Certifique-se de que o Python está instalado.
- PyTorch: Instale o PyTorch com suporte a CUDA (se você tiver uma GPU):
- Biblioteca Transformers: Instale a biblioteca
transformersda Hugging Face: - IPython (Opcional para usuários de Jupyter Notebook): Instale o IPython para exibir links clicáveis para arquivos:
Passo 2: Configurando o GPT-Neo para Seu Hardware
1. Lidando com Limitações de Memória da GPU
Para lidar com GPUs de memória limitada:
- Carregue o modelo em precisão reduzida (
float16). - Use o recurso
device_map="auto"para distribuir camadas entre a GPU e a CPU.
2. Alternância para CPU
Se a GPU não estiver disponível ou a memória for insuficiente, o script automaticamente alternará para o modo CPU.
Passo 3: O Código Completo
Abaixo está o código Python que configura o GPT-Neo e lida com a geração de texto de forma eficiente.
Código
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
import time
from datetime import datetime

# Força o uso da CPU se a GPU não tiver memória suficiente
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# Carrega o tokenizador
tokenizer = AutoTokenizer.from_pretrained("EleutherAI/gpt-neo-2.7B")

try:
    # Tenta carregar o modelo na GPU
    model = AutoModelForCausalLM.from_pretrained(
        "EleutherAI/gpt-neo-2.7B",
        torch_dtype=torch.float16  # Usa precisão reduzida para economizar memória
    ).to(device)
except RuntimeError as e:
    # Alterna para CPU se ocorrer um erro de memória
    print("Erro de memória na GPU. Alternando para CPU.")
    device = torch.device("cpu")
    model = AutoModelForCausalLM.from_pretrained("EleutherAI/gpt-neo-2.7B").to(device)

# Função para gerar texto em lotes
def generate_text_in_batches(prompt, total_length, batch_size):
    # Inicia o temporizador
    start_time = time.time()

    # Codifica o prompt e move para o dispositivo
    input_ids = tokenizer(prompt, return_tensors="pt").input_ids.to(device)
    generated_tokens = input_ids

    # Gera tokens em lotes menores
    for _ in range(0, total_length, batch_size):
        remaining_length = total_length - generated_tokens.shape[-1]
        current_batch_size = min(batch_size, remaining_length)

        # Gera o próximo lote de tokens
        with torch.no_grad():
            output = model.generate(
                generated_tokens,
                max_length=generated_tokens.shape[-1] + current_batch_size,
                do_sample=True,
                top_k=50,
                top_p=0.95,
                temperature=0.7,
                pad_token_id=tokenizer.eos_token_id
            )

        # Atualiza os tokens gerados
        generated_tokens = output

        # Para se o comprimento total for alcançado
        if generated_tokens.shape[-1] >= total_length:
            break

    # Decodifica os tokens em texto
    generated_text = tokenizer.decode(generated_tokens[0], skip_special_tokens=True)

    # Encerra o temporizador
    end_time = time.time()
    elapsed_time = end_time - start_time

    print(f"Tempo de resposta: {elapsed_time:.2f} segundos")
    return generated_text, elapsed_time

# Salva o texto gerado em um arquivo
def save_to_file(prompt, text, elapsed_time):
    # Obtém a data e hora atual
    current_time = datetime.now().strftime("%B, %A %d %Y at %I:%M%p")

    # Define o caminho do arquivo
    file_path = "./respostas_geradas.txt"

    # Salva o texto com metadados
    with open(file_path, "a") as file:
        file.write(f"Data e Hora: {current_time}\n")
        file.write(f"Pergunta (Prompt): {prompt}\n")
        file.write(f"Resposta Gerada: {text}\n")
        file.write(f"Tempo de Resposta: {elapsed_time:.2f} segundos\n")
        file.write("-" * 50 + "\n")

    print(f"Resultado salvo em: {file_path}")
    return file_path

# Parâmetros para geração
prompt = "Era uma vez"
total_length = 100  # Tokens a serem gerados
batch_size = 10     # Tamanho do lote

# Gera o texto
output, elapsed_time = generate_text_in_batches(prompt, total_length, batch_size)
print(output)

# Salva a saída em um arquivo
file_path = save_to_file(prompt, output, elapsed_time)

# Exibe link clicável (para usuários de Jupyter Notebook)
from IPython.display import FileLink
FileLink(file_path)
Passo 4: O Que Esse Código Faz?
- Otimiza Memória:
- Carrega o modelo com precisão reduzida (
float16). - Gera texto em lotes menores para evitar sobrecarga de memória.
- Carrega o modelo com precisão reduzida (
- Salva Respostas com Metadados:
- Cada resposta é salva com:
- Data e hora.
- Pergunta (prompt).
- Resposta gerada.
- Tempo de resposta.
- Cada resposta é salva com:
- Compatibilidade com Hardware Limitado:
- Alterna automaticamente para CPU se a GPU não tiver recursos suficientes.
Passo 5: Visualizando os Resultados
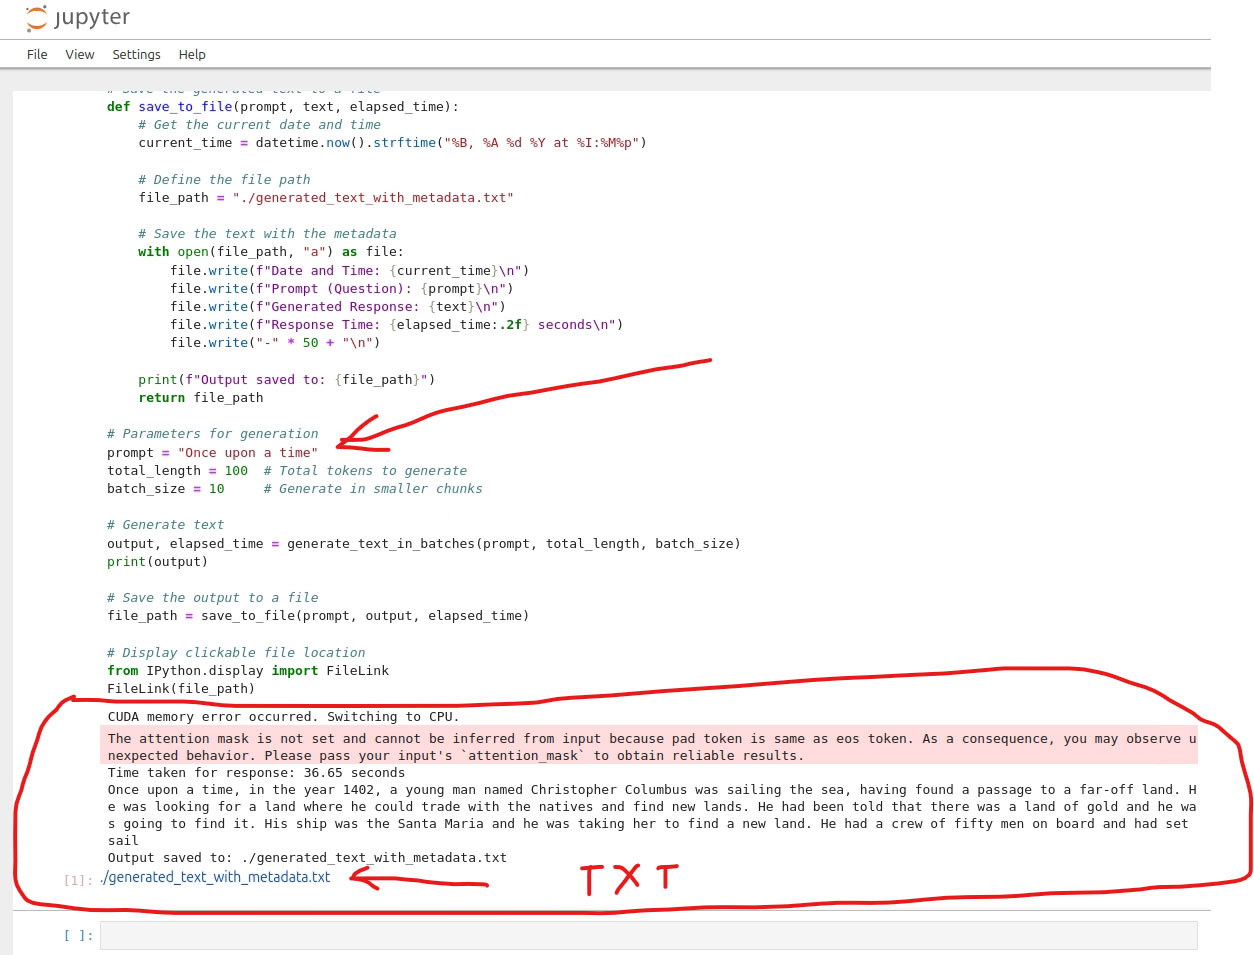
As respostas são salvas no arquivo respostas_geradas.txt, com entradas separadas por linhas. Um exemplo do conteúdo do arquivo:
Guia:
Este guia mostrou como:
- Configurar o GPT-Neo para gerar texto.
- Lidar com limitações de memória da GPU.
- Salvar respostas geradas com metadados úteis.
Com este código, você pode usar o GPT-Neo de maneira eficiente, mesmo em hardware limitado, para criar pipelines robustos de geração de texto.
O Jupyter Notebook está configurado para executar em segundo plano, e programei o código para que o sistema automaticamente utilize o CPU caso a GPU não consiga lidar com a tarefa. Essa abordagem garante que o processamento não seja interrompido, mas revelou uma limitação significativa no desempenho da GPU. Apesar de usar uma NVIDIA RTX 4070 SUPER, que é uma placa gráfica de alto desempenho, ela só conseguiu operar adequadamente ao reduzir o tamanho da tokenização para 50 ou menos. Essa restrição demonstra que o modelo GPT-Neo 2.7B requer GPUs ainda mais potentes e caras para atingir seu potencial máximo. Para quem busca melhores resultados, a configuração de uma instância na nuvem, como a AWS, com maior capacidade de processamento, é uma solução mais viável. Embora seja frustrante depender do CPU, ter programado o fallback para essa alternativa garante que o sistema funcione, ainda que com desempenho reduzido. Essa experiência reforça a importância de considerar recursos de nuvem para tarefas que demandam alto poder computacional. 🙁
O sistema funciona com os limites do investimento!
Advertisement:
A Inteligência Artificial e a Preparação para o Futuro dos Negócios
 Ser inteligente nos negócios significa estar preparado para mudanças inevitáveis que podem impactar o mercado. No livro The Personal MBA, Josh Kaufman apresenta o conceito de simulação contrafactual – imaginar possibilidades futuras e planejar para elas. Essa estratégia é tão relevante para o marketing digital quanto para qualquer outra área.
Imagine que sua empresa domina um nicho específico, como a venda de shakes de whey protein. Muitos negócios acreditam que o sucesso atual os torna imunes ao fracasso, mas o que aconteceria se um concorrente lançasse um shake melhor por um preço menor? E se um estudo mostrasse que whey protein faz mal? Empresas realmente inteligentes consideram esses cenários e criam estratégias para mitigar riscos antes que eles se tornem problemas reais.
Quer saber mais sobre como aplicar essa mentalidade em sua carreira e negócios? Leia The Personal MBA e descubra como pensar à frente pode transformar sua abordagem empresarial. Clique aqui para adquirir o livro e começar sua leitura agora.